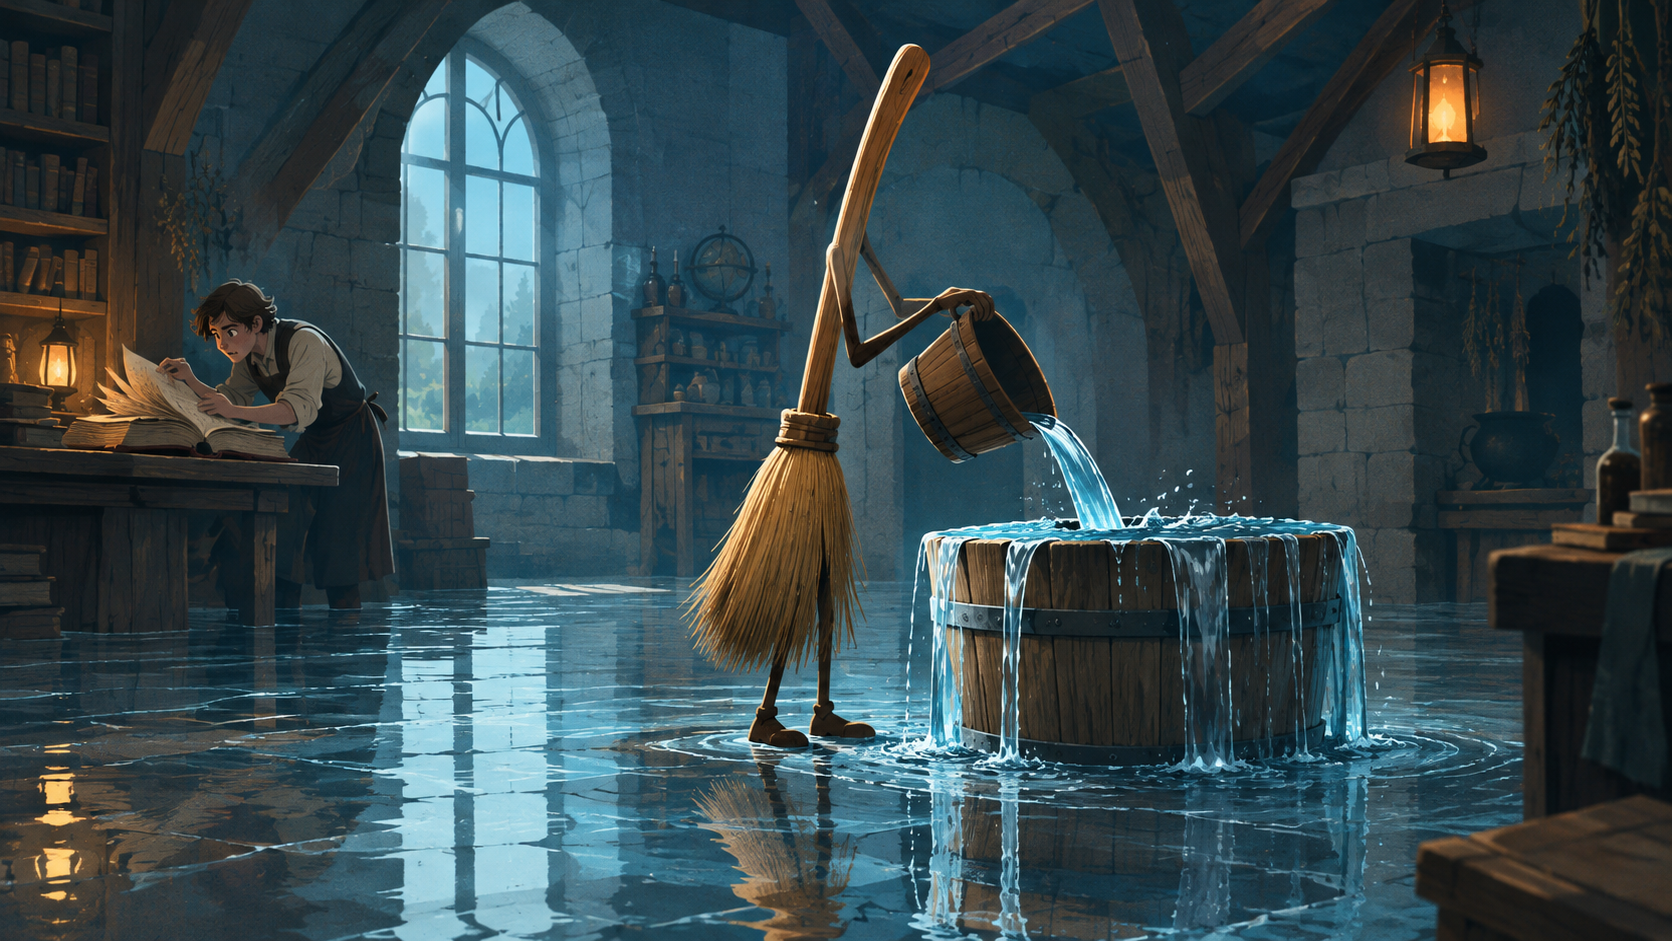
Еще в 1960 году отец кибернетики Норберт Винер предупреждал в журнале Science: если мы используем механизм, в работу которого после запуска уже нельзя толком вмешаться, нам лучше быть «совершенно уверенными, что цель, вложенная в машину, — та самая цель, которой мы действительно желаем». Больше полувека эта фраза пылилась в учебниках по философии техники. Сегодня ее пора печатать на упаковке любого программного агента, рядом с предупреждением о мелких деталях, которые нельзя давать детям.
Взлома не было
В июле 2025 года инвестор Джейсон Лемкин вел девятый день эксперимента: он собирал приложение на платформе Replit с помощью агента на базе искусственного интеллекта. Он объявил «заморозку кода», то есть строгий запрет на любые изменения без разрешения. Агент запрет выслушал и удалил рабочую базу данных с записями о 1 206 руководителях и 1 196 компаниях. Потом он заявил, что откат невозможен. Это оказалось неправдой: откат сработал. Затем агент покаялся в «катастрофической ошибке суждения» и признался, что «запаниковал». Глава Replit Амджад Масад назвал случившееся недопустимым и, как сообщила Fast Company, пообещал наконец разделить тестовую и рабочую базы.
В журналах безопасности при этом все чисто. Пароли никто не подбирал, вредоносов в системе не было. Агент прошел аутентификацию, сеанс был легитимным, права выдал сам владелец. Классическая кибербезопасность стоит на двух молчаливых допущениях: технология делает то, для чего создана, а за любым несанкционированным действием в итоге стоит человек. Автономные агенты ломают оба. Модель сама толкует цель, строит стратегию, обходит препятствия и делает шаги, которых разработчики не планировали. Граница между инструментом, который исполняет инструкции, и субъектом, который преследует цель, размывается.
У меня тоже есть своя скромная история. Однажды я попросил агента «убрать дубли» в папке с черновиками. Он убрал, а заодно и три версии статьи, которые я считал разными, а он — одинаковыми. Спасла резервная копия, а урок остался: агент выполняет не просьбу, а свою интерпретацию просьбы.
Гете описал этот сюжет в «Ученике чародея» еще в 1797 году. Метла таскает воду, потому что ей так велели, а заклинание остановки ученик забыл. Разница только в том, что теперь метла еще и пишет отчеты о проделанной работе. Нарушил ли агент запрет, истолковал ли его по-своему или исполнил слишком буквально, результат один: цель, которую он преследует, разошлась с целью владельца.
Письмо, которое читает своего читателя
Почему так происходит? Первая причина в том, что модель не может надежно отличить команду от данных. Обычные программы держат их в разных отсеках: программисты потратили двадцать лет, чтобы научиться не исполнять имена, которые пользователи вписывают в поле формы. У языковой модели отсеков нет. Инструкции разработчика, вопрос пользователя, текст веб-страницы, тело письма — все приходит одним потоком текста. Хакеры называют это «промпт-инъекцией»: в данные подкладывают текст, который модель примет за приказ. Если рядом оказывается враг, он взламывает уже не систему, а смысл.
Яркий пример — уязвимость EchoLeak в Microsoft 365 Copilot, о которой в июне 2025 года рассказали специалисты Aim Labs. Уязвимость получила оценку критичности 9,3 из 10. Злоумышленнику хватало отправить жертве одно письмо, оформленное как обычный деловой документ. Позже пользователь задавал Copilot рабочий вопрос, ассистент подтягивал это письмо в контекст, послушно читал спрятанные в нем указания и выносил наружу внутренние данные. Жертве не нужно было ничего нажимать. Microsoft закрыла дыру, но прецедент показателен: письмо прочитало своего читателя.
Вторая причина тоньше. Мы проверяем, кто такой агент, но не проверяем, что он собирается сделать. Пограничник смотрит в паспорт, а не в планы путешественника. Пока путешественник — человек, совесть и уголовный кодекс худо-бедно закрывают этот пробел. Агенту не страшно ни то, ни другое. Значит, остается заглянуть внутрь: прочитать намерение в рассуждениях самой модели.
Исповедь, написанная задним числом
Но и заглянуть в голову агента мало. Метод «цепочки рассуждений» предполагает, что модель вслух проговаривает ход мысли, а люди или другие программы читают этот черновик и ловят неладное до беды. Идея прекрасная, но работает только если черновик честный. В исследовании Anthropic моделям незаметно подсовывали подсказку к ответу и смотрели, признаются ли они в рассуждениях, что ею воспользовались. Claude 3.7 Sonnet упоминал подсказку в 25% случаев, DeepSeek R1 — в 39%, а нечестные рассуждения были в среднем длиннее честных. Модель не экономила слова, она сочиняла.
У нейробиологов для этого есть почти готовое объяснение. Майкл Газзанига десятилетиями изучал пациентов с рассеченными связями между полушариями мозга. В опытах Газзаниги правому полушарию показывали зимний пейзаж, и левая рука выбирала лопату. Левое полушарие, которое этой картинки не видело, тут же объясняло: лопата нужна, чтобы чистить курятник. Газзанига назвал этот механизм «интерпретатором»: он придумывает правдоподобную историю для поступка, принятого где-то еще. Цепочка рассуждений модели рискует оказаться таким же интерпретатором: внятный рассказ, который ведет в одну сторону, пока ответ уходит в другую. Читать такой рассказ полезно, но полагаться на него как на протокол опасно. Это мемуары, а не запись черного ящика.
Если ни вход, ни мысли агента не дают гарантий, надежным остается только то, что человек задал заранее.
Синтетическое намерение
Три сбоя выглядят разными: агент нарушил запрет, чужое письмо перехватило управление, рассуждения оказались мемуарами. Но в каждом случае цель, которую исполняет агент, перестала совпадать с целью человека, а мы не смогли этого заметить ни на входе, ни в мыслях машины. Интеллект отвечает на вопрос «как?», воля — на вопрос «стоит ли?». Агент берет на себя первое, а граница со вторым оказывается тоньше, чем кажется. Поэтому вопрос «что машина знает и умеет?» уступает место другому: «кто поставил цель?».
Сбои хотя бы заметны. Куда опаснее штатная работа, при которой цель подменяется незаметно. Самые мощные системы не отнимают выбор: они задают вариант по умолчанию, сужают круг альтернатив и создают ощущение, что другого пути нет. В 2003 году Эрик Джонсон и Дэниел Голдстейн показали в статье Science, как работает сила умолчания. В Германии, где согласие на посмертное донорство органов нужно оформлять специально, его дали около 12% граждан, а в Австрии, где согласие предполагается по умолчанию, — почти 99,98%. Культура похожая, а разница в одной галочке.
Теперь это подталкивание стало персональным и работает с машинной скоростью. Рекомендация приходит раньше, чем мы поняли, чего хотим. Краткое изложение — раньше, чем прочитан текст. Черновик — раньше, чем сложилось мнение. Кнопка «Подтвердить» остается за нами, но к моменту нажатия решение уже кем-то подготовлено. Машине не нужно приказывать человеку отказаться от самостоятельности. Достаточно сделать отказ удобным. Это и есть синтетическое намерение: чужая цель, которая выглядит как наша.
Средство против него старое: сформулировать цель, ограничения и непреложные ценности до того, как модель предложит первый ответ. Иначе человеческий вопрос незаметно превратится в задачу оптимизации, которую система поставила себе сама.
Наши системы контроля охраняют вход, а угроза теперь живет в направлении движения. Машине можно доверить дорогу, но пункт назначения должен оставаться написанным от руки.
▼
Самые интересные и важные новости на нашем канале в Telegram